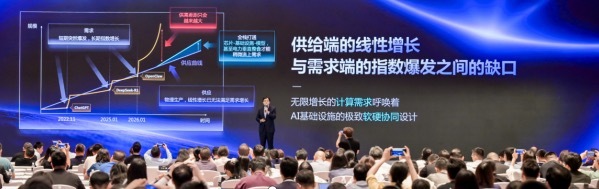
“计算需求在指数级攀升股市配资开户,今天,仅依靠产能的线性增长去堆叠算力,已经远远无法弥合供需之间持续扩大的缺口。”
2026年世界人工智能大会期间,无问芯穹联合创始人兼CEO夏立雪提出,当下的人工智能基础设施(AI Infra)“必须以极致的效率服务更大规模”。
基于规模与效率两大锚点,夏立雪从无问芯穹的AI生产力公式(AI生产力=智能资源规模×Token转化效率×AI生产力转化效率)出发,首次公布无问芯穹Agentic Infra的“前店后厂一中心”战略布局,涵盖三大核心技术能力与产品服务体系:“算力集散中心”:Agentic Infra自主式基础设施平台;“Token工厂”:Agentic MaaS大模型服务平台;“AI生产力商店”:Agentic Infra行业解决方案。
这套Agentic Infra产品与服务体系立足基础设施,向下汇聚能源和芯片,向上支撑模型和应用,不仅极致提升底层资源向AI生产力转化的规模和效率,更有着Agentic AI时代最显著的AI原生能力——用基础设施智能体蜂群赋能资源规模扩展、提效Token生产,并支持AgenticAI的持续进化。
发布会现场,夏立雪用千卡至万卡规模下完整推理服务技术栈揭示了一座Token工厂内部的可优化空间,“从网关、路由,到底层推理实例,Token工厂层层可优化、处处有增量”。
夏立雪还披露了无问芯穹首创的新一代推理系统优化成果——跨集群异构PD分离架构。
该架构首先用高性价比的广域网以太网把分布在各地的、已经建好的同构数据中心连起来,让算力强的集群做Prefill任务,让显存带宽高的集群做Decode任务。这一架构设计相当于让“偏科”的硬件只刷自己最擅长的题,可以极大提升大模型推理系统效率,是每座Token工厂都必备的“超级管线”。
夏立雪判断,随着跨集群异构PD分离架构的规模化落地,推理成本依然有10倍的下降空间。
现场,无问芯穹公布了在具身智能领域的全新探索——首个面向大规模具身任务的云边端一体化管理与调度平台。该平台首次把云端GPU集群、边缘算力节点和机器人真机设备统一接入到一个平台中,支持训练、数据采集、评测和真机执行等多种具身任务统一编排运行,有效解决了具身训练中资源分散、跨集群协同困难、任务角色复杂、真机状态不可见、启动链路长的问题。
同时,针对具身智能的训练与推理部署两大核心环节,夏立雪宣布了无问芯穹两项技术升级:面向具身智能的大规模真机强化学习训练框架RLinf V0.3,以及面向机器人与端侧AI场景的全栈的推理优化体系Mizar-Robo。
南方+记者 郜小平股市配资开户
倍悦网提示:文章来自网络,不代表本站观点。
热点资讯